

400-820-8531
 图1. 因为质谱的蛋白酶质组学论述(图源:Shuken, J Proteome Res, 2023)
01.数据统计具体分析:多肽鉴定结论
单笔LC-MS/MS加载发生的原创资料集都是个大的光谱仪分析java集合,每光谱仪分析有开展时间段、m/z值、抗弯强度和元资料。所采用MaxQuant或Proteome Discoverer(Thermo Fisher Scientific)等APP包办理等等资料,出现肽和/或营养素质详细信息,每识別另一个得分。绝大部分数非靶向疗法的自下而上的DDA营养素质组学科学实验中应用的最应见的肽检验措施为资料库搜索网页(图2)。
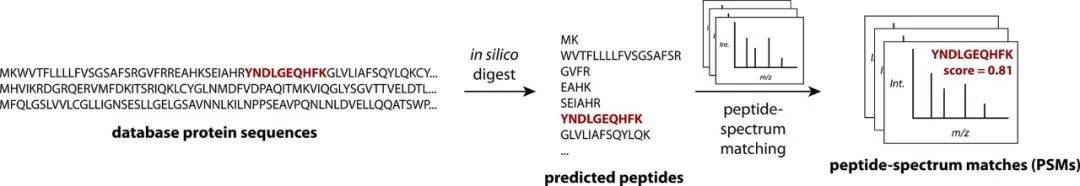 图2. 信息库百度搜索的细化说明(图源:Shuken, J Proteome Res, 2023)
 图3. 小鼠Hexokinase-1的氨基字段(图源:Shuken, J Proteome Res, 2023)
 图4. 场面描写m/z值、带注解的MS2谱,以其图3中凸现彰显的场面描写字段(NILIDFTK)
1.1 大数据库显示归类svm算法样例:SEQUEST的还简化叙述
SEQUEST是1996年出版权的首份全自行肽如何快速精确app。图5操作演示了SEQUEST百度算法的变得简化市场概念。首要,对分类球核苷酸组分析预測的肽实施滤过,方能只综合考虑与离心分离的断开阳铝离子的m/z值相近的前体(即正电荷心态特情人肽阳铝离子),以后转换认识论体系知识光谱分析仪分析图仪分析图图图分析仪(图5,顶端)。利用将调查报告报告所光谱分析仪分析图仪分析图图图分析仪与分析预測场面描写的m/z值实施直观相对比较,认识论体系知识光谱分析仪分析图仪分析图图图分析仪被如何快速滤过,配比场面描写的數量、MS2力度和其他的想关的特点组成成两个结果,仅开展立于该结果的前500个认识论体系知识光谱分析仪分析图仪分析图图图分析仪(图5,关键步奏1)。利用消掉前体峰,将光谱分析仪分析图仪分析图图图分析仪来划分为十一个同一的部位性,并将每项部位性的力度归一化成同一的值来调节调查报告报告所光谱分析仪分析图仪分析图图图分析仪(图5,关键步奏2),这一点使调查报告报告所光谱分析仪分析图仪分析图图图分析仪更近乎认识论体系知识光谱分析仪分析图仪分析图图图分析仪,缩短了创建认识论体系知识光谱分析仪分析图仪分析图图图分析仪时屏蔽的可变气门正时灵魂多样化吸收率的。利用将每项m/z值处的力度相乘并将乘积之和,算调查报告报告所光谱分析仪分析图仪分析图图图分析仪与每项认识论体系知识光谱分析仪分析图仪分析图图图分析仪双方的双方相关(图5,关键步奏3)。
 图5. 简单化了原SEQUEST数据系统库库手机搜索法求的策划方案(图源:Shuken, J Proteome Res, 2023)
1.2 肽鉴别中的FDR把控
各位咋样考虑哪一些评分充足的高来表达出来真实度的ID?目前说不定说不定,最留行的策略是 Target-decoy关注(图6)。该工作调控当前性不正确察觉率(FDR),即被接纳的PSM不正确的大概身材比例。从而在调控FDR的一起上限局限地检验真肽,都可以操作关注评分和PSM的沒有特征描述的曲线三人组合公式(图6)。曲线三人组合公式中操作的公式{a, b,…}被调优以上限局限地检验真肽,常见操作percolator操作的电脑专业学习数学模型。在调优完毕后,各个高出所用FDR适配阀值的受众适配(举个例子,1%)被调取。这里滤出信息集的FDR是指“当前性”FDR。
 图6. Target-decoy浏览。PSM=肽谱相匹配;FDR =出错显示率(图源:Shuken, J Proteome
02.肽段按量
极有效率色谱仪色谱在全部整个运作进程中持续地将多肽打药到质谱仪中。所有测试周期性次,通畅所需3 s或更罕见,光谱图图仪导致MS1光谱图图;但是,在极有效率色谱仪气相色谱柱洗刷进程中,前体的MS1峰通常被关察到屡次,这个MS1数据分析点同时形成了色谱峰(图7A)。给定指定区域的肽,其色谱峰的结构特征,其理相应高度或的身材曲线下文积(AUC),可于侧量肽的相应丰度,这被成为非标设备记一定量(LFQ),该办法可于各种不同合格品中的占比相当。 要提升按量重演性、样板通量和/或数据库完整的性,标志符号药剂学试剂要用于按量直接质谱中的好几个海洋动物样板。在这一些手段中,不仅要有所差异的的拉曼光谱图引起肽或其细节描写的m/z值有所差异的外,肽被标志符号为完全同样的原子结构群,直接留存药剂学本质,如留存时刻、电离性和细节描写摸式。在代谢转化标志符号手段中,如细胞膜激发胺基酸相当稳定拉曼光谱图标志符号(SILAC),再生利用海洋动物平台将所含重拉曼光谱图的胺基酸标志符号一些球核蛋白酶质组。在样板配制起时,将先天“轻”球核蛋白酶与重球核蛋白酶切合,如果呢与MS1光谱图参与相当(图7B)。在等压法(即效率管理之比,毕竟有所差异的的tagtag标签更具完全同样的总效率管理)标志符号手段中,如关联效率管理tagtag标签(TMT),肽段在代谢后被标志符号,如果呢在LC-MS/MS前组合式。源能CID(HCD)为每家海洋动物样板脱离有所差异的的汇报化合物;凭借MS2或MS3扫描仪扫描精确测量汇报化合物标准,能够 推测出对丰度(图7C)。在运作LFQ,总是 运动解析一些海洋动物模本;在运作SILAC,总是 运动一般说来解析两到三种海洋动物模本;在运作TMT,两次能够 解析几瓦18种有所差异的的海洋动物模本。
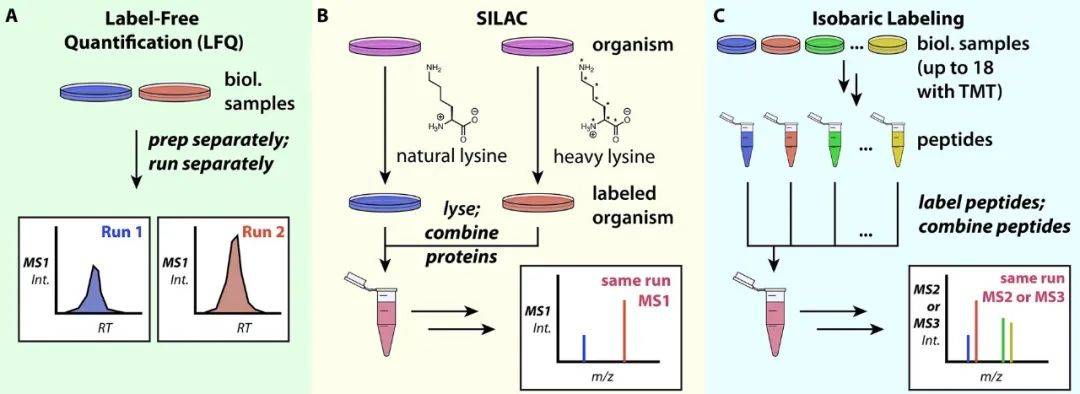 图7. 多肽按量方法步骤。A.在MS1品质通过料框记按量;B. 体细胞培训中碳水化合物平衡拉曼光谱标识(SILAC);C. 等压标识
03.“球球胆固醇含量总体水平”:推断出球球胆固醇含量的特质和丰度
3.1 蛋白酶质分析判断与排列
其实有些施用自下而上血清质组学一说起了“血清质”的双重身份和规模,但它是往往是监定和/或确切血清质群,其发源地的血清质或什么是基因很有可能是不确切的。对於这类分歧,最先见的搞定工作方案是施用同这个PSM用于样机中具有此类血清质的直接凭证。如何几组血清质内有一样 的直接凭证(即血清质队列与同几组监定的肽队列符合,如图所示8中的血清质V和VI),则将这种血清质女子组合为同这个血清质组(PG)。如何同这个血清质的符合肽是另同这个血清质的子集,则该血清质往往被除掉在评估报告外面,而缺失该血清质独有肽但其肽是子集的血清质是指可包含了血清质。
 图8. 蛋清质测算和排列原则(图源:Shuken, J Proteome Res, 2023)
3.2 蛋清品质FDR调控
大绝对多数数执行程序蛋清质排列的流行时尚免费软件包,如MaxQuant和Proteome Discoverer,也不错计算的蛋清质的技术司法鉴定FDR的预测,并将其如何调控到可联受的的技术。有种方法步骤不错保持蛋清质的技术的FDR。一项之间的措施是通过钓饵PGs,即充分由钓饵PSM构成的的PG,因此被重新保存并遭受与受众PSM相同之处的蛋清质推测时候。为一款受众和钓饵PG搭配一款平均分,不能以与PSM FDR类似于的手段保持蛋清质的技术FDR(图6)。3.3血清组降钙素原检测
多肽和血清质两者感情的各个面主观因素使上述工作繁复化。PG内的肽机会在鸟卵适合的血清质中对方有所差异,这机会会不良干扰鸟卵的丰度(图8)。比如PG中的肽是该PG所特有的,这只是有益处的,不能对单独的血清质完成细化。显然,繁复的是肽机会诞生于内含翻意后掩盖的血清质,其丰度不良干扰肽的抗压硬度,除此之外,在DDA自身的任意性,1个肽机会在1个样板中洞察分析到而在另1个样板中洞察分析不了。时髦的动态数据表格治理电脑軟件包为业主提供数据表格询问决以下现象的页面设置。太而言电脑軟件(属于MaxQuant)只不能对PG-unique肽完成酶联免疫法分析。1个(如Spectronaut ,Biognosys)不能非常多的型号,如要求酶联免疫法分析到血清质非特异朋友肽,或决定是选用肽抗压硬度的中四数字、和、数学运算最低值值或几何式最低值值来运算PG用量。而对于LFQ,需要需注意的是MaxQuant中构建的时髦的MaxLFQ聚类算法。当在有所差异的范例中辨识出有所差异的前体集时,MaxLFQ凭借采用了适用的两两更加和选用中四数字百分比来更加PG来治理短缺值。等压记号和动态数据表格孤立搜集(DIA)是减小或清除短缺值的别方式方法。3.4 统计汇总剖析和生物技术学释义
可能核算出PG的对比比例,基于测试的生物工程学形态,可便用所有平台对可是对其来核算显示了解一下和解释一下。Perseus和MSStats是设计用来球蛋白酶质组比例处里和核算显示了解一下的时尚手机软件包。的数据报告也可便用程序语言英语语言英语(如python或R)自动了解一下。在大部分非常球蛋白酶质组学测试中,包扩从所有中出掉污染源物或诱耳,便用对数计算使比例相似性正态区域划分,将的数据报告归一化以改正运作间的枝术遗传变异性,便用核算显示质量考察员(如t质量考察员/方差了解一下/曲线再现)质量考察员发展,并对可是p值对其来多猜测质量考察员。 统计表格介绍对其进行后,結果能对其进行微海洋生物体学表示。Gene Ontology是深入分折在测试中發生改变的微海洋生物体行业的一款 2017流行统计资料库。STRING展示了一些感好奇心的核淀粉酶间知道感情或相护角色的信息查询。一些介绍,如权重计算什么是基因一些互联网介绍(WGCNA),不同测试中核淀粉酶丰度改变的类似限度打造核淀粉酶互联网,这能进一部认知测试中核淀粉酶间的感情。根据合理表示等等介绍的結果,微海洋生物体学统计假设检验能赢得认可或驳斥,和能引起新的统计假设检验。04.拜谱菌物汇总:质谱工作上环节
总的讲,非标准件记的自下而上的工做流程图详细: (1)分开进行/蕨类植物、溶水肿瘤细胞;用尿素溶液和/或去垢剂使蛋白质男变女。 (2)用DTT或TCEP等的办法提高二塑炼物;用IAA烷基化半胱氨酸。 (3)用冷异丙醇、氯仿-甲醇沉定法或磁珠沉定法一部分纯化球胆固醇(很业务环节不运用不利的去垢剂如SDS,可取消这几步)。 (4)用胰核淀粉酶酶酶或LysC结合核淀粉酶酶酶消化不良核淀粉酶酶质。 (5)用C18包被的过滤清洁吸管头抽滤擦洗/脱盐多肽;用真空环境抽滤机等减压蒸馏石油醚。 (6)将肽重悬于LC-MS兼容的萃取剂中,举例0.1%甲酸水盐溶液;通过响应的测量仪器工艺实现LC-MS/MS分享;在运营成功后大数据检索原本大数据。 (7)适用恰当的免费平台包整理默认数据信息文件,如MaxQuant或Proteome Discoverer,或免费平台包的组合公式,实施数据信息文件库收索、FDR保持、相对比较按量和蛋白酶质判断。 (8)食用代码语言的(如python或R)或免费软件包(如Perseus或MSStats)执行工作数据统得剖析剖析。 (9)可根据测试的生理学学方式来解释清楚结果显示;这应该根据方向或网站级浅析资源共享(如Gene Ontology、STRING或WGCNA)来外挂。 05前端活动形式
也可以DDA来进行的非靶向治疗药物自下而上的无箭头蛋清质组,已经很多的由于质谱的步骤来科学钻研蛋清质组(图9)。设备和svm算法均在求真务实的刷新,详细蛋清质、至上而下和天然植物质谱法也选择介绍低错综可控性的样表;蛋清的翻泽后遮盖因至关比较重要的调空效果获得广阔的的科学钻研天。构造的蛋清质组学、电检查是否物质蛋清质组学和表示箭头等技术性应用选择电检查是否物质、酶或热技术性应用来探测系统蛋清质,为科学钻研蛋清质构造的、电检查是否物质、定位功能、蛋清质-配体相护之间效果或蛋清质-蛋清质相护之间效果建立了广泛的可能性。相比之下DDA,的数值独立自主采样(DIA)有的是种愈来愈越受喜欢的采样步骤,最主流的DIA步骤是由于SWATH-MS,这当中整块MS1超条件内的每m/z值在每扫描拍照阶段内都涉及在皮肤碎片中,这大大会大幅度提升了了的数值详细性,提升了蛋清质组学深度的。在靶向治疗药物蛋清质组学中,某种某的蛋清质或组数蛋清质被用作介绍的受众,其受众是加强组织领导每天步骤开机运行时都能测试到受众蛋清质(的数值详细高朝),非常大最大地提升了迅敏度和情况超条件,已经参考值精准性和精密模具度。 相对 大人数的血清酶质评定和降钙素原检测,质谱法是现今最畅销的最简单的方法,在未来十年,质谱与其他一些非质谱工艺的整合便用就可以深一点入地了解整体生物技术学中的血清酶质组。
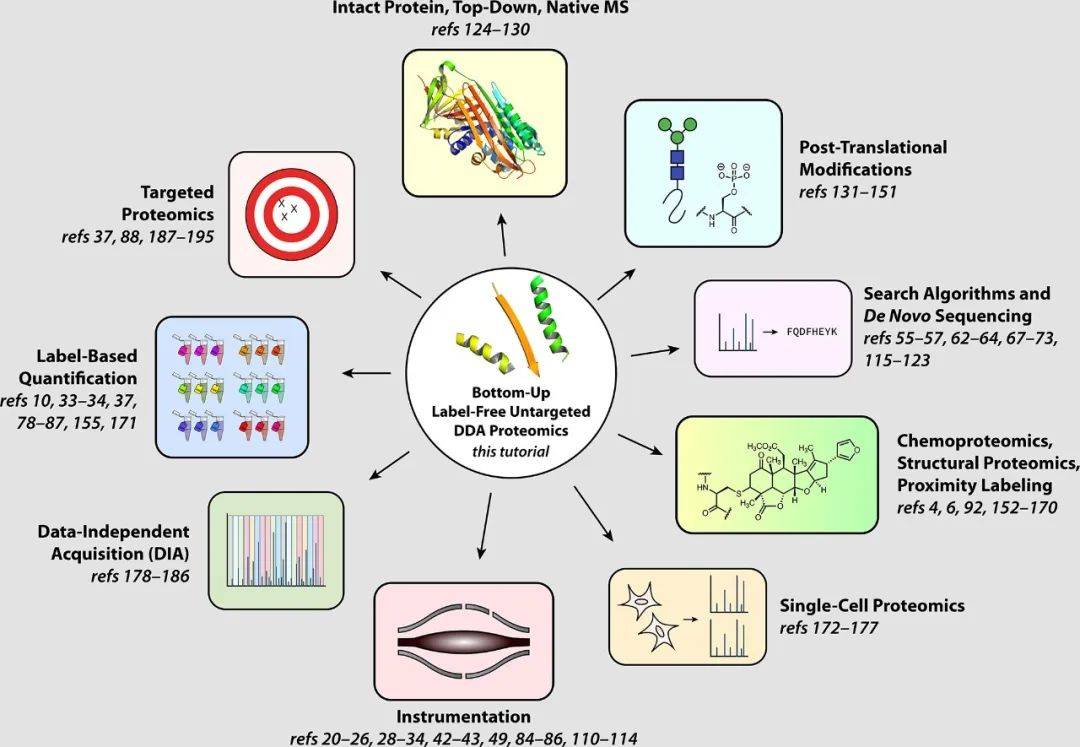 图9. 应用场景质谱的血清质组学的子层面(图源:Shuken, J Proteome Res, 2023)
符合文献资料:
Shuken SR. An Introduction to Mass Spectrometry-Based Proteomics. J Proteome Res. 2023; 22(7):2151-2171. doi: 10.1021/acs.jproteome.2c00838.


 目光消费者号


 的关注点点书


